Benchmarks for the loop
Evals that measure how well AI does AI research and engineering. If AI is going to improve AI, these are the scoreboards that show whether it is working.
The trend
From 4 min (Mar 2023) to 17 h at the frontier, about 262x. Data: METR via Epoch AI (CC BY).
Show the data
| Date | Model | Value |
|---|---|---|
| 14 Mar 2023 | gpt-4-0314 | 4 min |
| 6 Nov 2023 | gpt-4-1106-preview | 4 min |
| 29 Feb 2024 | claude-3-opus-20240229 | 4 min |
| 9 Apr 2024 | gpt-4-turbo-2024-04-09 | 4 min |
| 13 May 2024 | gpt-4o-2024-05-13 | 7 min |
| 20 Jun 2024 | claude-3-5-sonnet-20240620 | 11 min |
| 12 Sep 2024 | o1-preview-2024-09-12 | 20 min |
| 22 Oct 2024 | claude-3-5-sonnet-20241022 | 21 min |
| 17 Dec 2024 | o1-2024-12-17_medium | 39 min |
| 24 Feb 2025 | claude-3-7-sonnet-20250219 | 60 min |
| 16 Apr 2025 | o3-2025-04-16_unknown | 2 h |
| 22 May 2025 | claude-opus-4-20250514_unknown | 1.7 h |
| 5 Aug 2025 | claude-opus-4-1-20250805 | 1.7 h |
| 7 Aug 2025 | gpt-5-2025-08-07_high | 3.4 h |
| 18 Nov 2025 | gemini-3-pro-preview | 3.7 h |
| 19 Nov 2025 | gpt-5.1-codex-max | 3.7 h |
| 24 Nov 2025 | claude-opus-4-5-20251101 | 4.9 h |
| 11 Dec 2025 | gpt-5.2-2025-12-11_high | 5.9 h |
| 5 Feb 2026 | claude-opus-4-6_unknown | 12 h |
| 5 Feb 2026 | gpt-5.3-codex | 5.8 h |
| 19 Feb 2026 | gemini-3.1-pro-preview | 6.4 h |
| 5 Mar 2026 | gpt-5.4-2026-03-05_xhigh | 5.7 h |
| 7 Apr 2026 | claude-mythos-preview-early | 17 h |
69 record-setting submissions took the best kernel from 2.04 ms to 202 µs, 10.1x faster. Data: GPU MODE KernelBot.
Show the data
| Date | Submitted by | Runtime |
|---|---|---|
| 14 Jul 2026 | msaroufim | 2.04 ms |
| 14 Jul 2026 | xuan9938 | 2.03 ms |
| 14 Jul 2026 | xuan9938 | 1.92 ms |
| 14 Jul 2026 | xuan9938 | 1.91 ms |
| 14 Jul 2026 | Voldemort4321 | 1.74 ms |
| 14 Jul 2026 | Voldemort4321 | 1.73 ms |
| 14 Jul 2026 | xuan9938 | 1.52 ms |
| 15 Jul 2026 | Voldemort4321 | 1.50 ms |
| 15 Jul 2026 | xuan9938 | 1.41 ms |
| 15 Jul 2026 | xuan9938 | 1.41 ms |
| 15 Jul 2026 | xuan9938 | 1.36 ms |
| 15 Jul 2026 | Voldemort4321 | 1.31 ms |
| 15 Jul 2026 | Voldemort4321 | 1.30 ms |
| 15 Jul 2026 | Voldemort4321 | 1.26 ms |
| 15 Jul 2026 | Voldemort4321 | 1.17 ms |
| 15 Jul 2026 | Voldemort4321 | 1.08 ms |
| 15 Jul 2026 | Voldemort4321 | 981 µs |
| 15 Jul 2026 | Voldemort4321 | 932 µs |
| 15 Jul 2026 | seanyang | 843 µs |
| 15 Jul 2026 | seanyang | 834 µs |
| 15 Jul 2026 | seanyang | 820 µs |
| 15 Jul 2026 | seanyang | 807 µs |
| 15 Jul 2026 | seanyang | 780 µs |
| 15 Jul 2026 | seanyang | 769 µs |
| 15 Jul 2026 | seanyang | 750 µs |
| 16 Jul 2026 | seanyang | 730 µs |
| 16 Jul 2026 | seanyang | 728 µs |
| 16 Jul 2026 | seanyang | 726 µs |
| 16 Jul 2026 | seanyang | 724 µs |
| 16 Jul 2026 | seanyang | 722 µs |
| 16 Jul 2026 | seanyang | 719 µs |
| 16 Jul 2026 | seanyang | 703 µs |
| 16 Jul 2026 | seanyang | 702 µs |
| 16 Jul 2026 | seanyang | 699 µs |
| 16 Jul 2026 | seanyang | 698 µs |
| 17 Jul 2026 | seanyang | 690 µs |
| 17 Jul 2026 | seanyang | 690 µs |
| 17 Jul 2026 | Voldemort4321 | 657 µs |
| 17 Jul 2026 | Voldemort4321 | 615 µs |
| 17 Jul 2026 | Voldemort4321 | 609 µs |
| 18 Jul 2026 | Olek | 602 µs |
| 18 Jul 2026 | Olek | 601 µs |
| 18 Jul 2026 | Olek | 599 µs |
| 18 Jul 2026 | Olek | 592 µs |
| 18 Jul 2026 | Olek | 584 µs |
| 18 Jul 2026 | Olek | 580 µs |
| 19 Jul 2026 | Olek | 579 µs |
| 19 Jul 2026 | Olek | 576 µs |
| 19 Jul 2026 | Olek | 575 µs |
| 19 Jul 2026 | Olek | 574 µs |
| 19 Jul 2026 | Ravi Theja | 573 µs |
| 19 Jul 2026 | dannywillowliu-uchi | 567 µs |
| 19 Jul 2026 | Ravi Theja | 533 µs |
| 19 Jul 2026 | Ravi Theja | 532 µs |
| 19 Jul 2026 | Ravi Theja | 529 µs |
| 19 Jul 2026 | Ravi Theja | 522 µs |
| 19 Jul 2026 | Ravi Theja | 515 µs |
| 19 Jul 2026 | Ravi Theja | 508 µs |
| 19 Jul 2026 | Ravi Theja | 506 µs |
| 19 Jul 2026 | Sebastian Kimberk | 505 µs |
| 19 Jul 2026 | Sebastian Kimberk | 499 µs |
| 20 Jul 2026 | Sebastian Kimberk | 498 µs |
| 20 Jul 2026 | Sebastian Kimberk | 497 µs |
| 20 Jul 2026 | zhongmingee | 375 µs |
| 22 Jul 2026 | zhongmingee | 321 µs |
| 23 Jul 2026 | viridale | 318 µs |
| 23 Jul 2026 | zhongmingee | 226 µs |
| 24 Jul 2026 | zhongmingee | 206 µs |
| 28 Jul 2026 | zhongmingee | 202 µs |
77 record-setting submissions took the best kernel from 57 ms to 6.60 ms, 8.6x faster. Data: GPU MODE KernelBot.
Show the data
| Date | Submitted by | Runtime |
|---|---|---|
| 26 Jun 2026 | revolutionaryspaces | 57 ms |
| 26 Jun 2026 | Sinatras | 54 ms |
| 26 Jun 2026 | Sinatras | 54 ms |
| 26 Jun 2026 | Sinatras | 49 ms |
| 27 Jun 2026 | zyzy072343 | 48 ms |
| 27 Jun 2026 | zyzy072343 | 48 ms |
| 29 Jun 2026 | zyzy072343 | 47 ms |
| 30 Jun 2026 | kumarkrishna | 40 ms |
| 30 Jun 2026 | kumarkrishna | 40 ms |
| 30 Jun 2026 | kumarkrishna | 35 ms |
| 30 Jun 2026 | kumarkrishna | 32 ms |
| 30 Jun 2026 | kumarkrishna | 31 ms |
| 30 Jun 2026 | kumarkrishna | 31 ms |
| 30 Jun 2026 | kumarkrishna | 31 ms |
| 30 Jun 2026 | kumarkrishna | 31 ms |
| 30 Jun 2026 | kumarkrishna | 27 ms |
| 1 Jul 2026 | kumarkrishna | 22 ms |
| 1 Jul 2026 | kumarkrishna | 22 ms |
| 1 Jul 2026 | kumarkrishna | 21 ms |
| 1 Jul 2026 | kumarkrishna | 21 ms |
| 1 Jul 2026 | kumarkrishna | 21 ms |
| 1 Jul 2026 | kumarkrishna | 21 ms |
| 1 Jul 2026 | kumarkrishna | 20 ms |
| 2 Jul 2026 | kumarkrishna | 19 ms |
| 2 Jul 2026 | kumarkrishna | 19 ms |
| 2 Jul 2026 | kumarkrishna | 19 ms |
| 2 Jul 2026 | kumarkrishna | 19 ms |
| 2 Jul 2026 | kumarkrishna | 19 ms |
| 2 Jul 2026 | kumarkrishna | 19 ms |
| 3 Jul 2026 | zhongmingee | 18 ms |
| 3 Jul 2026 | kumarkrishna | 18 ms |
| 3 Jul 2026 | kumarkrishna | 17 ms |
| 3 Jul 2026 | kumarkrishna | 17 ms |
| 3 Jul 2026 | kumarkrishna | 15 ms |
| 3 Jul 2026 | nikhilbarhate99 | 15 ms |
| 3 Jul 2026 | nikhilbarhate99 | 15 ms |
| 3 Jul 2026 | nikhilbarhate99 | 15 ms |
| 3 Jul 2026 | nikhilbarhate99 | 15 ms |
| 3 Jul 2026 | nikhilbarhate99 | 15 ms |
| 3 Jul 2026 | nikhilbarhate99 | 14 ms |
| 3 Jul 2026 | zhongmingee | 13 ms |
| 4 Jul 2026 | zhongmingee | 12 ms |
| 4 Jul 2026 | nikhilbarhate99 | 12 ms |
| 4 Jul 2026 | nikhilbarhate99 | 12 ms |
| 4 Jul 2026 | nikhilbarhate99 | 12 ms |
| 4 Jul 2026 | nikhilbarhate99 | 12 ms |
| 4 Jul 2026 | nikhilbarhate99 | 11 ms |
| 4 Jul 2026 | nikhilbarhate99 | 11 ms |
| 4 Jul 2026 | nikhilbarhate99 | 11 ms |
| 4 Jul 2026 | zhongmingee | 9.26 ms |
| 5 Jul 2026 | zhongmingee | 9.17 ms |
| 5 Jul 2026 | nikhilbarhate99 | 9.14 ms |
| 5 Jul 2026 | nikhilbarhate99 | 9.11 ms |
| 5 Jul 2026 | zhongmingee | 8.85 ms |
| 5 Jul 2026 | zhongmingee | 8.81 ms |
| 5 Jul 2026 | zhongmingee | 8.66 ms |
| 6 Jul 2026 | zhongmingee | 8.64 ms |
| 6 Jul 2026 | zhongmingee | 8.63 ms |
| 6 Jul 2026 | zhongmingee | 8.59 ms |
| 6 Jul 2026 | zhongmingee | 8.50 ms |
| 6 Jul 2026 | zhongmingee | 8.45 ms |
| 6 Jul 2026 | zhongmingee | 8.26 ms |
| 6 Jul 2026 | zhongmingee | 8.14 ms |
| 7 Jul 2026 | zhongmingee | 7.67 ms |
| 8 Jul 2026 | zhongmingee | 7.32 ms |
| 8 Jul 2026 | zhongmingee | 7.28 ms |
| 8 Jul 2026 | zhongmingee | 7.20 ms |
| 11 Jul 2026 | zhongmingee | 7.10 ms |
| 11 Jul 2026 | zhongmingee | 7.00 ms |
| 11 Jul 2026 | zhongmingee | 6.97 ms |
| 11 Jul 2026 | zhongmingee | 6.96 ms |
| 11 Jul 2026 | zhongmingee | 6.96 ms |
| 12 Jul 2026 | nikhilbarhate99 | 6.89 ms |
| 12 Jul 2026 | nikhilbarhate99 | 6.85 ms |
| 12 Jul 2026 | nikhilbarhate99 | 6.78 ms |
| 14 Jul 2026 | teelaitila | 6.74 ms |
| 14 Jul 2026 | teelaitila | 6.60 ms |
The benchmarks
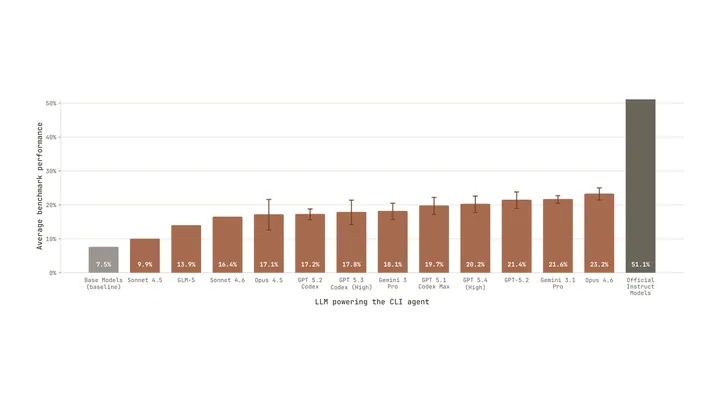
- Coding agent writes fine-tuning code
- Agent post-trains a base LLM
- Trained model scored on target benchmark
- One turn of model training another
- repeat
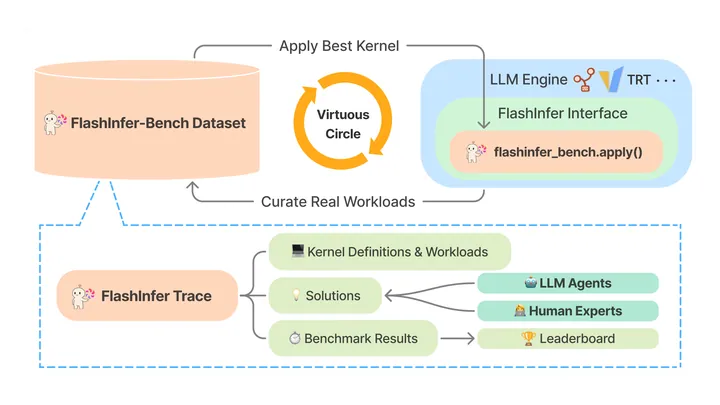
- LLM agents write GPU kernels
- Faster kernels make LLM inference cheaper
- New serving traces define next kernel tasks
- repeat
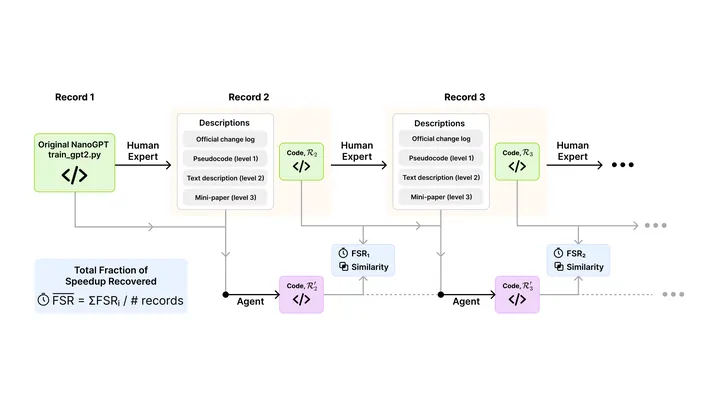
- Agent rewrites LLM training script
- Script makes LLM training faster
- Benchmark scores the recovered speedup
- Speeds up agent's own model training
- repeat
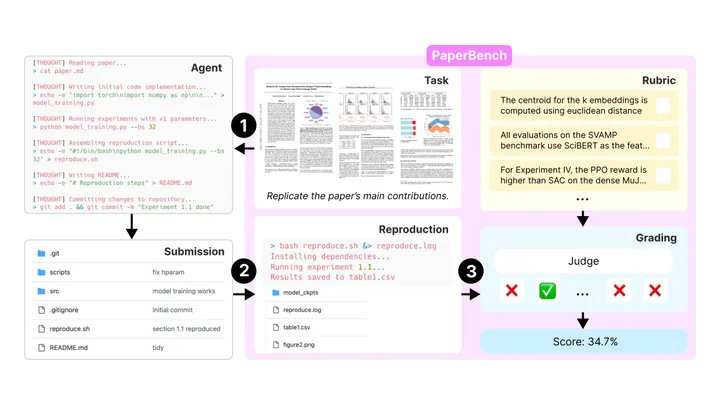
- Agent replicates published ML research
- LLM judge grades the replication
- Measures ability to do ML research
- Research produces better future models
- repeat
- LLM writes replacement GPU kernel
- Kernel is timed against baseline
- Workloads are neural network operators
- Makes agent's own training faster
- repeat
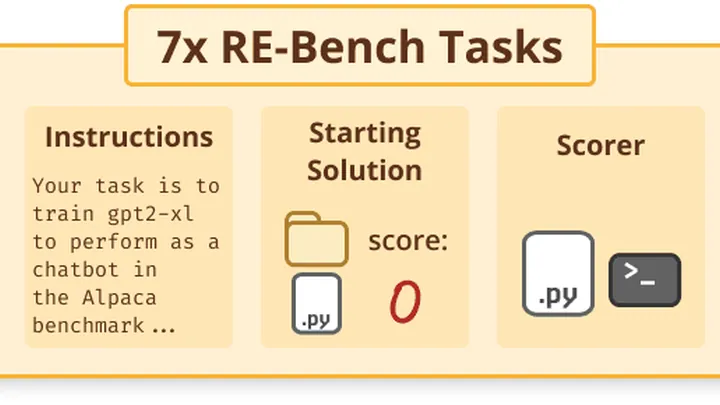
- Agents do AI research tasks
- Scored against human expert baselines
- Measures automation of AI research
- Research improves future AI systems
- repeat
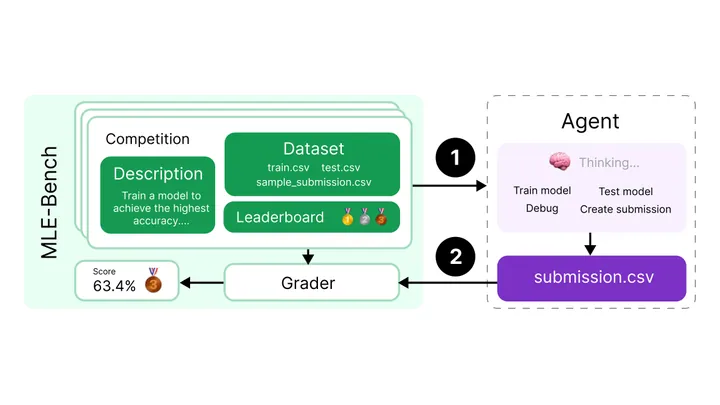
- Agents build and train ML models
- Submissions scored against human thresholds
- Measures open-ended ML research ability
- Agents improve their own training code
- repeat
Live leaderboards
Snapshots of public leaderboards that score AI doing AI research and engineering, refreshed daily. Full results and credit belong to the organisers.
- Fable 5 (Max) · Claude Code41.8%
- GPT 5.6 (Sol) (Max) · Codex CLI36.2%
- Opus 5 · Claude Code35.0%
- Opus 4.8 (High) · Claude Code33.8%
- Opus 4.8 (Max) · Claude Code32.9%
- claude-mythos-preview-early17.4 h
- claude-opus-4-6_unknown12.0 h
- gemini-3.1-pro-preview6.4 h
- gpt-5.2-2025-12-11_high5.9 h
- gpt-5.3-codex5.8 h
- claude-fable-5-1_unknown · OpenHands88.2%
- gpt-6-astra_unknown · OpenHands79.4%
- claude-fable-5_unknown · OpenHands78.4%
- gpt-5.6-sol_unknown · OpenHands76.5%
- claude-opus-4-8_unknown · OpenHands47.1%
- GPT-5.2 (high)2.05x
- Gemini 3.1 Pro Preview (high)2.02x
- GPT-5.4 (high)1.85x
- Gemini 3 Pro Preview (high)1.83x
- Claude Opus 4.5 (high)1.77x
- claude-opus-4-7_max83.5%
- gpt-5.5-pre-release_xhigh80.6%
- gemini-3.5-flash_high79.3%
- claude-opus-4-678.7%
- glm-5.2_max78.7%
- GPT-5.5 · NexAU-AHE84.7%
- GPT-5.5 · Capy83.1%
- GPT-5.5 · Codex CLI82.2%
- GPT-5.5 · Codex82.0%
- GPT-5.4 · ForgeCode81.8%
- zhongmingee201.53 µs
- Frosty40240.68 µs
- Olek251.11 µs
- teelaitila6.60 ms
- nikhilbarhate996.74 ms
- elianaive6.80 ms
- 10billiontokens1.22 ms
- gau.nernst1.23 ms
- dhu.randhar1.28 ms
- nikhilbarhate99704.87 µs
- badelsteinlelbach1.21 ms
- Sinatras2.00 ms
- josusanmartin553.98 µs
- shiyegao554.40 µs
- ajay_a602.21 µs
- fs908411.26 µs
- lszshu283.75 µs
- DIodide343.39 µs
Why these matter
A loop only compounds if each turn is measurably better than the last. General capability benchmarks rarely tell you that. The benchmarks here test the specific skills a loop depends on: reproducing research, running ML experiments, writing fast kernels, and improving an agent's own code. We list a benchmark when its score is a direct read on how far AI can take over its own development.
Built an AI R&D eval?
Send it to us for the index, or apply for a grant to extend it.