·12 Nov 2026·AI R&D evals
New best on PostTrainBench: Fable 5.1 (Max) · Claude Code (44.6%)
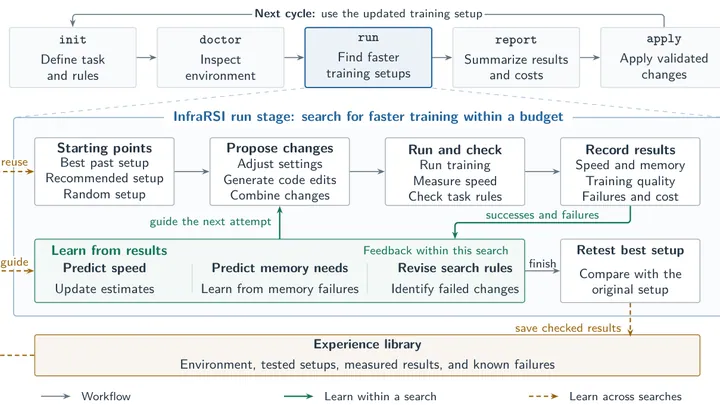
The loop: AI agents perform post-training on a base model to improve its benchmark average. The resulting model is evaluated on a benchmark specifically designed to measure AI driven engineering tasks.
Claude Code achieved a new high score of 44.6% on PostTrainBench by successfully post-training a base model.
loop fit 10/10via Epoch AI Benchmarking Hub (CC BY)